AI 开始接手完整项目:从 GitHub 的 Rust 重写到模型自动部署
如果让 AI 帮你维护一个博客,你希望收到什么?一份操作教程,还是一篇已经配好图、能正常打开、确实发布到网站上的文章?
这个区别,恰好能解释最近一轮 AI Agent 热点。越来越多讨论开始围绕完整的工程任务展开:读项目、修改代码、检查结果,再把成品送到用户面前。
过去一周,GitHub 与 AWS 各自发布的工程文章,给这个变化提供了两个具体观察窗口。
原创 AI 概念插画:把开发过程想成搭桥,既要有人施工,也要有人确认桥能通行。本文两张插画由内置图片生成器制作,并非厂商产品截图。
最近发生了什么?两条值得关注的官方消息
9 月 16 日,GitHub 披露了 Copilot Agent 运行时向 Rust 迁移的工程案例。 官方文章称,团队使用 Copilot 应用和 CLI,将原本基于 TypeScript、Node.js 与 V8 的运行时重写为超过 80 万行生产 Rust 代码。这里的数字描述重写后的代码规模,不能直接理解为“AI 独立完成了 80 万行代码”,更不能据此推算所有项目的效率。GitHub 官方文章
9 月 18 日,AWS 介绍了用编程 Agent 部署 Hugging Face 模型的方法。 方案通过六个开放的技能,将部署知识交给 Agent,流程涵盖模型服务、伸缩、监控和资源清理。文章同时报告:缺少相关知识时,Agent 可能选错服务容器;一次请求返回 HTTP 200,也可能还没产生真正需要的回答。AWS 官方文章
两条消息都发生在 2026 年 9 月,以上事实核对截至 9 月 22 日。它们属于厂商披露的工程案例,本文没有复现实验。下面讨论的是这些案例带来的启发,不是对整个行业效率的统计结论。
为什么“完整任务”比一段代码更值得关注?
以给博客加一个搜索框为例,写出输入框可能只占很少一部分工作。真正让它能用,还得找到文章索引、处理中文查询、考虑手机布局、检查空结果,并确认发布后资源路径正确。
当 AI 只提供代码片段时,这些衔接工作仍然由你完成。当 Agent 能读取仓库、调用工具、观察错误并继续修改时,交给它的任务单位就可以扩大到一个有明确结果的功能。
我认为这轮变化最值得关注的是:我们开始能把“做到什么程度才算完成”写进任务,而不只是描述“应该生成什么”。
| 任务 | 只有产出时 | 真正交付时 |
|---|---|---|
| 写技术文章 | 得到一份 Markdown | 来源可追溯、图片可加载、线上正文正确 |
| 修复页面 | 代码已经修改 | 问题能复现、修复能验证、原有功能正常 |
| 整理数据 | 输出了一张表 | 字段含义清楚、缺失值有处理、结果能追溯 |
| 部署应用 | 发布命令运行结束 | 服务可访问、关键操作可用、故障能定位 |
这张表也是判断 Agent 演示的一个方法:看它交付的是哪一列。
Skills 为什么频繁出现在 Agent 讨论里?
可以把模型想成一位能力不错的新同事。它懂编程,也能阅读错误信息,但它未必知道你的项目今天使用什么构建命令、文章放在哪个目录、上线后要检查哪个地址。
这些知识需要以某种形式交给它。Skills 可以组织操作说明、参考材料与辅助脚本,让重复工作有一套可读取、可更新的做法。它的价值取决于内容是否准确,以及 Agent 是否在正确的任务里使用它。
对个人项目来说,不必一开始就追求复杂的自动化系统。先把自己每次都要重复解释的几件事写下来,就已经很有帮助:
- 这个项目的入口在哪里,哪些文件负责什么;
- 怎样构建,怎样在本地检查;
- 什么算完成,出了问题怎样恢复。
这也是本文对 AWS 案例的理解:把会变动的工作知识放进可维护的材料,通常比期待模型恰好记得所有细节更可控。
看懂一条 Agent 交付流水线
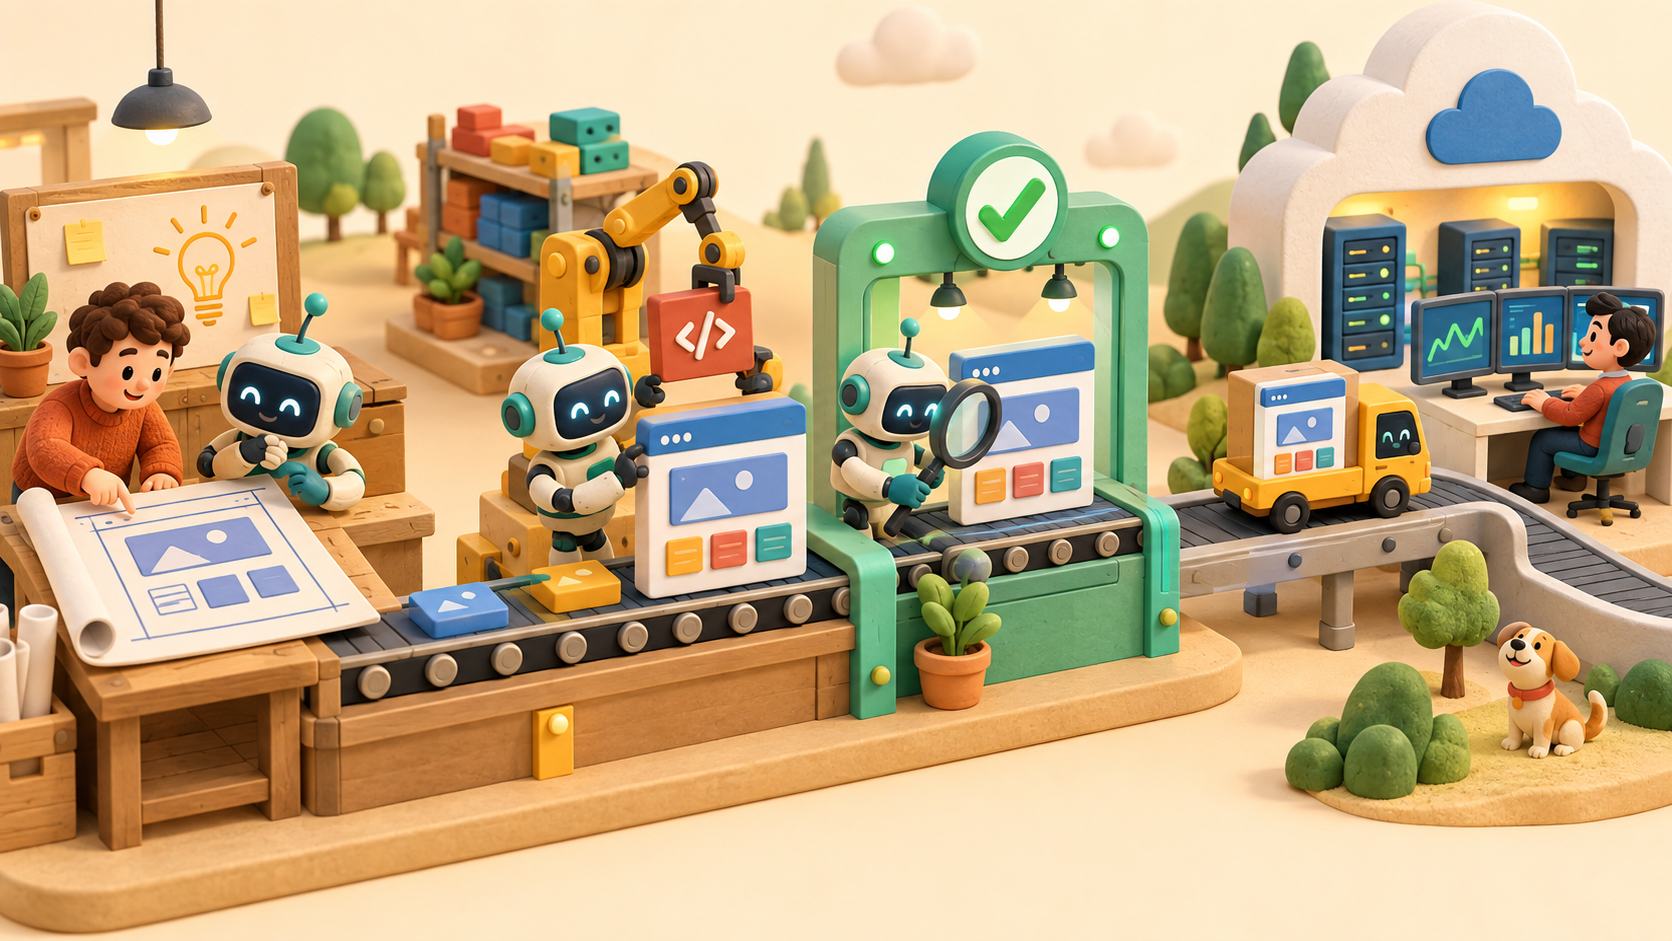
从左到右:明确需求 → 实现功能 → 检查结果 → 发布与观察。图中的检查门代表验收条件,云端的监控屏代表上线后的实际状态。
这四个阶段分别解决不同的问题。
明确需求,解决“做什么”。 “优化我的网站”范围太大;“让手机上的文章目录不遮挡正文,并保留桌面布局”就具体得多。
实现功能,解决“怎么做”。 Agent 需要读取已有实现,在现有结构里修改。一个能单独运行的示例,未必能直接嵌进真实项目。
检查结果,解决“是否做到”。 改动应当接受与目标对应的检查。修改图片路径,就检查图片是否能打开;修改计算逻辑,就用有明确预期的样本核对。
发布与观察,解决“别人能否用到”。 本地成功、远端收到提交、网站部署完成,是三个不同状态。中间任何一步停下,都可能让用户看到旧版本。
对使用者来说,最有价值的变化是减少这些阶段之间的手工接力。对开发者来说,最需要投入的部分则是明确各阶段的输入和验收条件。
普通人可以怎样开始?拿一个小项目练习
如果你刚接触 Agent,可以先选一个自己熟悉、结果容易判断的小任务。例如:为博客增加一篇文章,给课程项目修复一个按钮,或把一份公开资料整理成网页。
下面这份任务描述可以直接按需改写:
1 | |
这个例子的关键是结果具体:读者最后能打开文章,而维护者知道发布了哪个版本。至于用几个 Agent、调用多少次模型,都只是实现方式。
熟悉流程以后,再逐步增加任务复杂度。每增加一种外部操作,就同步补上对应的验收办法。例如增加邮件发送功能时,先在测试收件箱核对;增加付费资源时,把资源范围和结束条件写进任务。
学编程的人,该把精力放在哪里?
看完大型重写案例,很容易产生一种焦虑:以后是否不需要学基础了?
我的判断是,基础知识会影响你能把任务交给 AI 到什么程度。你是否理解数据流、接口和版本管理,决定了你能不能发现“看起来完成”和“实际上完成”之间的差距。
不妨把学习目标从“独自敲出每一行”扩展为三个能力:
- 把问题说具体。 写清楚输入、输出、约束和异常情况。
- 读懂关键实现。 能判断数据去了哪里,操作会改变什么。
- 设计有效验收。 找到能证明结果的测试、样本或线上检查。
你可以让 AI 帮忙搭建课程作业的框架,但要自己解释关键函数;可以让它写测试,但要确认测试覆盖的是题目要求;可以让它发布网页,但要亲自理解部署地址与源代码之间的关系。
这样积累的能力,会随着工具变强而更有用。
接下来值得观察什么?
GitHub 的迁移案例和 AWS 的部署实践,让“AI 参与完整工程流程”变得更具体。但我们仍然需要更多关于维护成本、失败处理和长期质量的公开证据。
下一次看到 Agent 发布新闻,可以多追问几句:它能处理什么范围的任务?什么时候需要人接手?成功如何判断?换一个陌生项目,还能保持表现吗?
对自己的项目,则可以从一个很实际的目标开始:让 AI 完成一件你能检查、能复现、也能继续维护的小事。 一篇真正上线的文章、一个确实修好的页面,都能比一段炫目的演示更清楚地告诉你,工具已经走到了哪里。
参考资料
- GitHub,2026-09-16:Migrating the GitHub Copilot runtime to Rust, using Copilot
- AWS,2026-09-18:Deploy Hugging Face models on Amazon SageMaker AI with coding agents